Zestig offertes nakijken kostte ons vorige maand twee minuten en twee dollarcent. Niet het uitlezen van die offertes, dat deed al een taalmodel. De controle erop.
Dat verschil is belangrijker dan het klinkt. Zolang een mens elke uitkomst van een AI-systeem moet nalopen, verkoop je gereedschap: de klant blijft zelf verantwoordelijk voor het resultaat. Zodra de controle zelf betrouwbaar machinaal kan, kun je het afgeronde werk verkopen. En dat is precies wat er deze maand technisch een stap dichterbij kwam.
Het nieuws: modellen die geen tekst schrijven, maar oordelen
OpenAI bracht op 6 oktober 2026 de Decisions API uit in publieke beta. Je stelt er geen open vraag aan, maar een vaste vraag met vaste antwoorden: klopt deze bewering, welke van deze vier categorieën past, welk cijfer hoort hierbij. Je krijgt geen tekst terug maar een antwoord met een kans eraan, en dat is iets waar gewone software direct iets mee kan. De API draait op GPT-6 Luna, kost 0,10 dollar per miljoen invoertokens en is volgens OpenAI tot tien keer sneller dan dezelfde vraag via de Responses API.
Nieuw is het idee niet. TypeSafe doet dit al langer met Jev, een model dat precies dezelfde drie soorten oordelen geeft (kans, keuze, score) voor 0,042 dollar per miljoen tokens. Het verschil zit in beeld: Jev leest alleen tekst, de Decisions API kijkt ook naar een afbeelding. Voor wie een gescande bon, een foto van een order of een advertentie wil laten beoordelen scheelt dat een aparte stap.
De Decisions API is wel nadrukkelijk nog beta. Er is nog geen caching op invoertokens, wat bij classificatiewerk met een vaste instructie direct in de kosten te merken is, en ontwikkelaars melden dat de kansen bij keuzevragen nog niet altijd goed geijkt zijn. Voor een experiment is dat geen probleem, voor een proces waar facturen of offertes doorheen gaan wel.
Wat geen van beide partijen publiceert, is wie er beter oordeelt. Er is geen gepubliceerde vergelijking tussen Jev en de Decisions API op dezelfde dataset. Wie dit serieus gebruikt, test het dus zelf op eigen voorbeelden, en dat is ook precies wat wij deden.
Wat wij ermee doen: de controle automatiseren, niet het werk
Wij gebruiken zo'n beslismodel niet om werk te doen, maar om werk na te kijken. In een tool die offertes uitleest en er een businesscase van maakt, haalt een taalmodel de bedragen en de onderdelen uit de offerte. Daarna stelt een tweede model per ingevuld veld de vraag: staat dit er echt zo? Blijft de kans onder de drempel, dan heet het veld verdacht en kijkt er een mens naar.
De cijfers daarvan zijn de reden dat we er vertrouwen in hebben. Zestig offertes kosten ongeveer twee minuten en twee dollarcent, oftewel ruim achtduizend tokens per offerte. De eerste ronde haalde er drie echte fouten uit die bij handmatig nakijken waren blijven zitten. En om te weten of een schone uitslag iets betekent, draaiden we een tegenproef met expres verminkte bedragen: alle zeven verminkte velden werden afgekeurd.
Dat laatste is het punt waar het bij veel AI-projecten misgaat. Een controle die altijd groen geeft is geen controle. Pas als je hebt aangetoond dat hij fouten die je er zelf instopt ook echt vindt, mag je op een schone uitslag vertrouwen.
Hoe zo'n controle eruitziet
De opzet is simpeler dan mensen verwachten. Het model dat het werk doet en het model dat het nakijkt zijn gescheiden, en de controle krijgt bewust niet te zien wat de uitlezer ervan maakte voordat hij zijn eigen oordeel heeft gegeven. Anders laat hij zich meeslepen door een antwoord dat er al ligt.
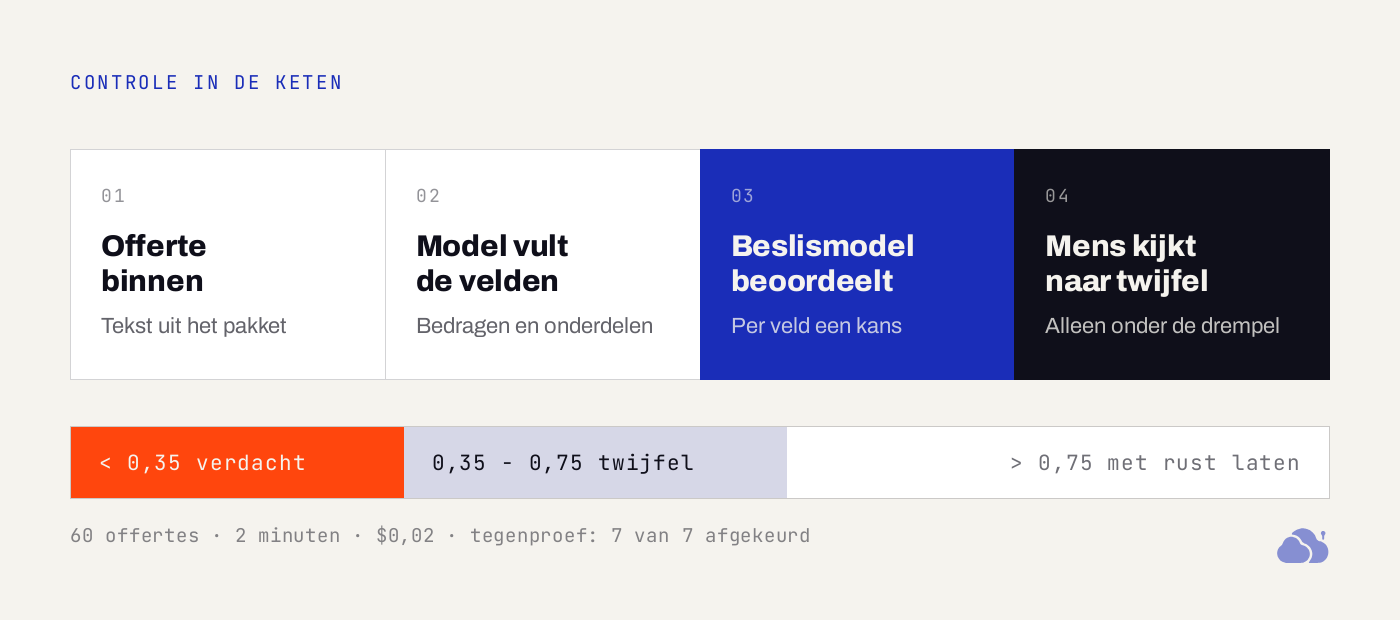 De controle hangt tussen het werk en de mens in. Alleen wat onder de drempel scoort, kost nog aandacht.
In onze opzet gaan er per offerte twee vragensets naartoe. De eerste ziet alleen de offertetekst en beoordeelt wat erin staat. De tweede ziet de offerte mét de ingevulde velden en beoordeelt per getal of het er echt zo staat. Onder een kans van 0,35 heet een veld verdacht, tussen 0,35 en 0,75 twijfelachtig, en daarboven laten we het met rust.
Waarom dit over verdienmodellen gaat, niet over techniek
De vraag wie de controle doet, bepaalt wat je verkoopt. Sequoia-partner Julien Bek schreef er in maart 2026 een essay over dat veel is gedeeld: Services: The New Software. Zijn observatie is dat er per dollar aan software ongeveer zes dollar aan diensten wordt uitgegeven, en dat software die het werk zelf aflevert dus een veel grotere markt aanspreekt dan software die iemand helpt het werk te doen.
Hij onderscheidt twee modellen. Een copilot is gereedschap voor een professional die verantwoordelijk blijft voor de uitkomst. Een autopilot levert het afgeronde werk en wordt betaald per resultaat. Het verschil tussen die twee is geen marketing maar techniek: je kunt pas per resultaat afrekenen als je weet wanneer het resultaat klopt.
Jurre Machielsen, mede-oprichter van DenkBot, vat samen waar wij in de praktijk op uitkomen: "We kunnen nu alles wat we bouwen als mini-dienst aanbieden. De uitdaging zit erin om op microniveau end-to-end oplossingen te bieden. Met modellen als Jev kunnen we steeds meer laten controleren, waardoor de menselijke controle steeds verder naar achteren schuift."
Dat is iets anders dan de agent die alles doet. Het gaat om één afgebakend proces per keer: offertes doorrekenen, inkoopfacturen inboeken, telefoongesprekken omzetten naar tickets. Klein genoeg om de uitkomst te kunnen controleren, groot genoeg om echt tijd te schelen.
Wat kan nu wel, en wat nog niet
Wat nu kan:
- Een uitkomst machinaal beoordelen. Per veld een kans, met een drempel die je zelf zet. Dit draait bij ons in productie en kost centen per ronde.
- Een tegenproef draaien. Verminkte waarden erin, en kijken of de controle ze eruit haalt. Dat maakt het verschil tussen een controle en een geruststelling.
- Beeld beoordelen. Sinds de Decisions API kan dat zonder losse vision-stap, voor wie met scans of foto's werkt.
Wat nog niet kan:
- De laatste twijfelgevallen overnemen. Van onze zestig offertes bleef er na herstel één melding over: een offerte op naam van een bedrijf voor een woonhuis met 0 procent btw. Of dat zakelijk of particulier is, staat ook voor een mens niet vast. Zo'n geval los je niet op met een beter model, maar met een afspraak over wie beslist.
- Blind vertrouwen op een vergelijking die niemand publiceerde. Noch OpenAI noch TypeSafe heeft cijfers naast elkaar gezet. Je eigen testset is voorlopig de enige echte maatstaf.
- Elk proces uit handen geven. Niet elke klant wil dat. Bij laadinfrastructuur bijvoorbeeld is grip houden belangrijker dan een stap minder, omdat er fysieke installaties en facturatie aan hangen.
Wat dit voor jou betekent
Kijk niet naar wat AI kan maken, maar naar wie het nakijkt. In vrijwel elk proces dat wij bij mkb-bedrijven tegenkomen zit een stap waar iemand alles nog eens overleest, niet omdat het vaak misgaat, maar omdat niemand durft te zeggen hoe vaak het goed gaat. Dat is de duurste stap, en tegelijk de stap waar je het eerst iets aan kunt doen.
De volgorde die bij ons werkt is deze. Laat eerst een model het werk doen en een tweede model het resultaat beoordelen. Meet dan hoe vaak de controle fouten vindt die je er zelf instopt. Pas als dat getal klopt, schuif je de menselijke controle naar achteren: van alles nakijken naar alleen de gevallen waar het model twijfelt.
Wij hebben vandaag geen prijslijst met kant-en-klare mini-diensten. Wel bouwen we elk proces zo dat de controle erbij hoort, en dat is de voorwaarde om straks niet een bouwtraject te verkopen maar het werk zelf. Offertes doorrekenen, facturen en administratie en klantenservice zijn de processen waar wij die stap nu het vaakst zetten.
Veelgestelde vragen
Wat is een beslismodel precies?
Een beslismodel beantwoordt een vaste vraag met een kans in plaats van met tekst. Je geeft het een stuk context en een vraag met vaste antwoordopties, en krijgt per optie terug hoe waarschijnlijk die is. Omdat de uitkomst een getal is, kan gewone software er een regel aan hangen: onder deze grens gaat het naar een mens.
Is de OpenAI Decisions API beter dan Jev van TypeSafe?
Dat is op dit moment niet te zeggen, omdat er geen onafhankelijke vergelijking is gepubliceerd. De Decisions API kan ook afbeeldingen lezen en kost 0,10 dollar per miljoen invoertokens; Jev leest alleen tekst en kost 0,042 dollar. Welk van de twee beter oordeelt op jouw soort werk, meet je met een eigen testset van voorbeelden waarvan je het juiste antwoord al kent.
Kun je de menselijke controle helemaal weglaten?
Nee, en dat is ook niet het doel. De controle verschuift van alles nakijken naar alleen de gevallen waarin het model twijfelt. In onze eigen controleronde bleef van zestig offertes er één over waar ook een mens niet zonder navraag uitkomt.
Wat kost het om een proces zo te laten controleren?
De modelkosten zijn verwaarloosbaar: onze controleronde over zestig offertes kostte ongeveer twee dollarcent. Het werk zit in het bepalen van de juiste vragen, de drempels en de tegenproef. Dat is eenmalig werk per proces en daarna draait het mee bij elke wijziging.
Wat is service-as-a-software?
Service-as-a-software is het model waarbij je het afgeronde werk verkoopt in plaats van het gereedschap waarmee iemand dat werk doet. De klant betaalt per afgehandeld geval of per resultaat, niet per gebruiker of per ontwikkeltraject. Het vraagt wel dat de leverancier kan aantonen wanneer de uitkomst klopt, en dat is precies waar machinale controle voor nodig is.
Klaar om dit in jouw bedrijf toe te passen?
Plan een gratis adviesgesprek en ontdek hoe wij jouw organisatie slimmer maken met AI op maat.
Plan gratis adviesgesprek